


Индексация сайта: почему страницы не появляются в Яндексе и Google
 Консультация
Публикация может корректно открываться в браузере, иметь заголовок, текст и ссылки, но поискового трафика всё равно не будет, если робот не включил её в свою базу. Особенно заметна проблема после запуска нового раздела, смены адресов, обновления шаблонов или массовой загрузки карточек.
Ошибку часто ищут не там. Владельцы меняют метатеги, добавляют объём текста или многократно отправляют один и тот же адрес на переобход. Между тем причина может находиться в серверном ответе, запрете индексирования, неправильном каноническом указании, отсутствии внутренних переходов или в том, что материал почти полностью повторяет другой документ.
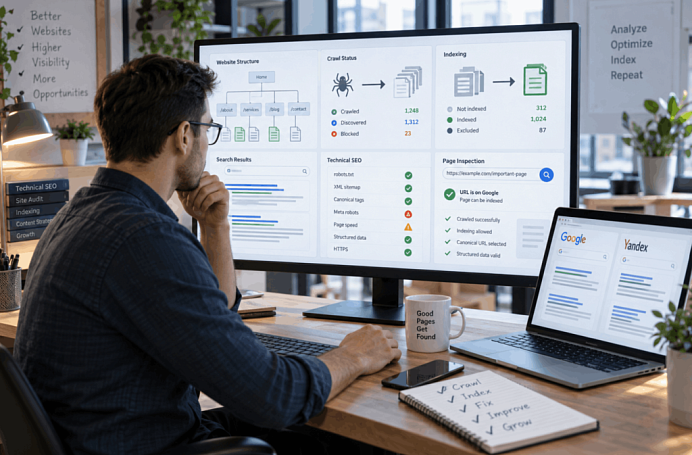
Ниже разберём, как провести проверку индексации без лишних действий и понять, на каком этапе возникает сбой. Для системной работы полезно рассматривать эту задачу вместе с техническим аудитом, структурой и SEO-оптимизацией сайта.
Индекс и обход: в чём разница
Поисковый робот сначала должен узнать о новом адресе. Источником могут быть внутренние переходы, карта сайта, внешняя ссылка или ранее известная версия. После обнаружения робот пытается получить документ, анализирует код ответа и содержимое, сопоставляет его с похожими материалами и решает, какую версию считать основной. Только затем ресурс может участвовать в выдаче.
Эти этапы не равнозначны. Наличие записи в Sitemap.xml означает лишь, что поисковой системе подсказали адрес. Ответ 200 также ничего не гарантирует: доступный документ может быть признан дублем, получить запрет через meta robots или быть выбран второстепенной копией. И наоборот, отсутствие позиции по целевой фразе ещё не говорит о проблеме с индексом — возможно, документ уже хранится в базе, но уступает конкурентам по релевантности и качеству.
Поэтому первым вопросом должно быть не «почему нет трафика», а «известен ли поисковику конкретный адрес и какой статус ему присвоен».

Как установить реальный статус адреса
Оператор site: удобен для быстрой ориентировочной проверки, но не подходит как единственный инструмент. Число результатов меняется, часть документов может не показываться, а отсутствие конкретного адреса в такой выдаче не всегда означает его полное исключение из базы.
Для точной диагностики используйте сервисы для владельцев ресурсов. Они показывают сведения об обходе, разрешении индексирования, выбранной основной версии и обнаруженных ограничениях. Проверять стоит не только один проблемный материал, но и несколько соседних документов того же шаблона: если симптомы совпадают, причина, скорее всего, заложена в общей настройке.
На крупном проекте полезно собрать выборку по типам: категории, карточки, статьи, страницы фильтров, пагинация, региональные версии. Такой срез быстрее выявляет массовую ошибку, чем ручной просмотр десятков случайных адресов.
Индексация сайта в Яндексе
В Яндекс Вебмастере проверяют сведения о конкретном адресе и общую статистику разделов. Если робот не может получить документ, сервис обычно указывает техническую причину или фиксирует проблему обхода. При доступности важно дополнительно посмотреть, не исключён ли материал как дубль, малополезная версия или страница с запрещающей директивой.
Отдельно оценивайте историю изменений. После переноса проекта старые правила могут продолжать влиять на новые адреса: например, на рабочий домен случайно переносится запрет из тестовой среды. При массовом выпадении раздела именно такой сценарий следует проверять одним из первых.
Индексация сайта в Google
В Google Search Console инструмент проверки адреса показывает, известен ли документ системе, когда его посещал робот и какая версия выбрана основной. Формулировки «обнаружена, но не проиндексирована» и «просканирована, но не проиндексирована» описывают разные ситуации: в первом случае обход ещё не состоялся либо отложен, во втором содержимое уже получено, но включение в базу не произошло.
Если технических запретов нет, следует оценить архитектуру, число похожих адресов и самостоятельную ценность материала. Повторная отправка без изменения причины редко даёт устойчивый эффект.
Почему страницы не индексируются
У одного симптома может быть несколько источников. Ниже перечислены причины в порядке, удобном для практической проверки: от обнаружения и доступа к качеству документа. До составления списка стоит определить масштаб: одна публикация, отдельный шаблон или весь проект после релиза.
Адрес нигде не связан с остальным проектом
Если до нового материала нельзя дойти по обычным ссылкам, робот может обнаружить его поздно. Карта сайта помогает, но не заменяет навигацию. Для приоритетной публикации создайте логичный переход из тематического раздела и убедитесь, что ссылка присутствует в HTML.
В robots.txt осталось слишком широкое правило
Один Disallow способен закрыть каталог целиком. Особенно рискован перенос файла с тестовой площадки. При этом robots.txt регулирует обход, а не служит универсальным средством удаления из индекса. Подробное объяснение есть в материале о влиянии robots.txt на индексацию.
Запрет передаётся через meta robots или HTTP-заголовок
Директива noindex бывает прописана в шаблоне, настройках системы управления или X-Robots-Tag. После отмены ограничения робот должен заново получить документ. Если обход одновременно заблокирован, обновлённый сигнал может не считываться.
Сервер отвечает не тем кодом
Для обычной доступной публикации ожидается 200. Перенаправление ведёт поискового робота на другой адрес, 404 и 410 сообщают об отсутствии, 403 способен закрыть доступ, а повторяющиеся 5xx указывают на сбой инфраструктуры. Если ошибка возникает на уровне шаблона или сервера, её разумно передать в техническую поддержку сайта.
Основной адрес указан неверно
rel="canonical" помогает обозначить предпочтительную версию среди похожих документов. Ошибочная ссылка на главную, соседнюю категорию или старую региональную копию способна сделать текущую публикацию второстепенной. Сверяйте каноническое указание с редиректами, картой сайта и внутренними переходами.
Генерируется множество почти одинаковых вариантов
Сортировки, параметры, технические метки и фильтры создают лишние комбинации. Робот расходует обход на копии, а поисковая система получает противоречивые сигналы. Нельзя закрывать все фильтры автоматически: часть из них может быть полноценной посадочной под реальный спрос.
Содержимое фактически пустое
Ответ 200 не спасает шаблон, в котором нет товара, описания, характеристик или полезной информации. Такой документ может восприниматься как мягкая ошибка 404. Проверяйте не только код сервера, но и то, что реально получает поисковый робот.
Ключевые данные появляются только после выполнения сценариев
Если основной текст, товары или навигация загружаются JavaScript после обращения к внешнему API, поисковик может получить неполную версию. Критичные элементы лучше делать стабильно доступными без пользовательского действия. При проектировании сайтов под SEO это учитывают ещё до запуска.
Материал слишком похож на существующий
Поисковой системе нет смысла хранить несколько почти одинаковых документов. Типичные случаи — пустые теги, региональные копии без локальных отличий, карточки с одинаковым описанием. Полезнее добавить характеристики, фактические данные, условия, примеры и ответы на отдельный спрос, чем искусственно увеличивать количество слов.
После миграции нарушено соответствие старых и новых адресов
При смене системы управления, домена или структуры часто забывают про 301-перенаправления, оставляют старые записи в карте, создают цепочки редиректов или теряют навигационные переходы. До релиза нужна таблица соответствий и контроль технических сигналов по основным шаблонам.
Для быстрой оценки удобно сопоставить наблюдаемый симптом с первой проверкой. Таблица не заменяет анализ, но сокращает число лишних действий.
|
Наблюдение |
Что проверить сначала |
Вероятное направление |
|
Адрес неизвестен сервису вебмастера |
Внутренние переходы, Sitemap.xml, доступность |
Проблема обнаружения |
|
Робот получил запрет |
robots.txt, meta robots, X-Robots-Tag |
Ограничение обхода или включения |
|
Получен 3xx, 4xx или 5xx |
Серверный ответ и цепочку перенаправлений |
Техническая ошибка |
|
Выбрана другая основная версия |
Каноническое указание, дубли, внутренние ссылки |
Конфликт версий |
|
Документ просканирован, но не включён |
Сходство с другими материалами, ценность, качество шаблона |
Отбор содержимого |
|
В базе есть, а позиции нет |
Соответствие запросу, конкурентность, коммерческие и поведенческие факторы |
Ранжирование, а не индекс |
Если один и тот же признак наблюдается у десятков адресов, ищите общий источник: шаблон, модуль, правило сервера или настройку системы управления. Массовая проблема редко решается ручной отправкой каждого документа.
Диагностика по шагам
-
Откройте проверку конкретного адреса в Яндекс Вебмастере и Google Search Console. Сохраните статус, дату обхода и сведения об основной версии.
-
Проверьте ответ сервера без браузерных предположений: код, конечный адрес после перенаправлений и отсутствие циклов.
-
Посмотрите robots.txt, meta robots и X-Robots-Tag. Убедитесь, что рабочий документ не получил случайный запрет.
-
Сравните фактический адрес с rel="canonical" и с тем, что указано в карте сайта.
-
Найдите внутренние переходы на материал. Для важной посадочной должен существовать понятный путь от тематически близких разделов.
-
Сравните содержание с соседними документами. Если различия минимальны, решите, нужна ли отдельная версия вообще.
-
При активном JavaScript проверьте, доступна ли ключевая информация в обработанном документе робота.
-
После исправления запросите повторный обход для приоритетных адресов и наблюдайте изменение статуса, не отправляя их десятки раз подряд.
После завершения процедуры проверьте ещё несколько документов того же типа. Если они показывают одинаковый результат, исправление нужно вносить на уровне шаблона. Такой подход быстрее и безопаснее, чем точечная корректировка отдельных публикаций.
Как ускорить индексацию сайта
Ускорять имеет смысл только доступный и корректно настроенный документ. Поисковые системы не обещают моментального включения после отправки запроса. Основная задача — дать роботу понятный маршрут и непротиворечивые сигналы.
В карте оставляйте актуальные основные адреса с ответом 200. Новые материалы связывайте с уже известными разделами, а после существенного исправления используйте штатные инструменты переобхода. О назначении XML-карты подробнее рассказано в материале зачем нужна Sitemap.xml.
Не стоит создавать десятки технических копий ради «частоты обновления», массово менять даты без изменения содержания или постоянно отправлять один и тот же адрес. Такие действия не исправляют архитектуру и способны затруднить анализ. Гораздо полезнее стабильная работа сервера, понятная навигация, ограниченное число дубликатов и содержательные отличия между посадочными.
Частые ошибки владельцев
В попытке быстро вернуть трафик легко выбрать действие, которое не связано с причиной. Перед таблицей ещё раз разделим задачи: запрет обхода, удаление из базы, объединение дублей и перенаправление — это разные механизмы.
|
Действие |
Почему это слабое решение |
Рабочая альтернатива |
|
Ежедневно отправлять один адрес на переобход |
Робот снова увидит тот же запрет или дубль |
Сначала устранить источник, потом запросить повторную обработку |
|
Считать оператор site: точным отчётом |
Выдача не предназначена для полного аудита базы |
Смотреть сведения в сервисах для владельцев |
|
Добавлять в Sitemap.xml всё подряд |
Технические копии и редиректы засоряют карту |
Оставлять только актуальные основные документы |
|
Закрывать любой дубль через robots.txt |
Робот может не получить нужный сигнал о другой версии |
Выбирать между перенаправлением, каноническим указанием, noindex и ограничением обхода по задаче |
|
Наращивать текст без новой информации |
Количество символов не создаёт самостоятельную ценность |
Добавлять характеристики, факты, условия, сравнения и ответы на отдельный спрос |
Самая дорогая ошибка — одновременно менять несколько технических механизмов, не зафиксировав исходный статус. После этого сложно понять, какое действие помогло, а какое создало новую проблему. Для крупных изменений полезен журнал правок и контрольная выборка адресов до и после релиза.
Кейсы
Ниже приведены типовые ситуации из практики SEO и разработки.
Типовая ситуация 1. Запрет с тестовой версии попал на рабочий домен
Исходная задача: после редизайна новый раздел долго не появлялся в поиске. Проблема: в общем шаблоне сохранилась запрещающая директива, которую использовали во время разработки. Решение: убрать ограничение, проверить остальные типы документов, обновить карту и запросить повторную обработку ключевых адресов. Результат: робот снова получил разрешение на работу с разделом.
Вывод: после публикации нужно проверять несколько шаблонов, а не только главную.
Типовая ситуация 2. Каталог наполнен, но роботу трудно до него добраться
Исходная задача: сотни карточек были перечислены в XML-карте, однако значительная часть оставалась неизвестной поисковым системам. Проблема: из категорий отсутствовали обычные HTML-переходы, а параметры создавали много лишних вариантов. Решение: восстановить навигацию, убрать технический шум из карты, определить основные версии и сократить число дублей. Результат: структура стала прозрачнее для обхода.
Вывод: XML-карта дополняет архитектуру, но не заменяет её.
Типовая ситуация 3. Браузер показывает контент, а робот получает заготовку
Исходная задача: новая посадочная корректно выглядела у посетителей, но долго не попадала в базу. Проблема: основной текст и навигация появлялись только после выполнения JavaScript и обращения к внешнему интерфейсу. Решение: сделать критичную информацию доступной в исходном документе и проверить обработанную версию. Результат: поисковый робот стал получать полноценное содержимое.
Вывод: визуальная исправность для пользователя не равна технической доступности для поисковой системы.
Итог
Если поисковый документ пропал или не появился после публикации, полезнее начать со статуса и фактов, а не с повторных отправок. Последовательно проверяются доступ, код сервера, запрещающие директивы, основная версия, навигация, карта и самостоятельность содержания. После технической правки можно запрашивать повторный обход.
Когда сбой затрагивает целый раздел или возник после переноса, нужна проверка шаблонов и общей архитектуры. Такая работа обычно быстрее точечных исправлений и снижает риск повторения проблемы при следующих обновлениях.
Расскажите
Обсудить проект
вашем проекте
Обсудить проект


